Jag har låtit agenter bygga Qodellen i en loop i knappt fem dygn. Det går, men inte av de skäl jag trodde, och de intressantaste lärdomarna handlar om granskning och om att inte lita på ett grönt test.
Qodellen har en backlog som aldrig tar slut, en "parkeringsplats" där jag lägger sidofynd så jag slipper tappa fokus, och en kö med forskningsfrågor. Jag hann inte läsa dem, än mindre göra dem. Så jag byggde Fabriken: en loop som tar nästa uppgift ur köerna, bygger den i en egen worktree, låter en annan modell granska och landar den bara om testerna är gröna. Namnet är lite pompöst... men det är ju iaf vad den gör.
Hur den ser ut
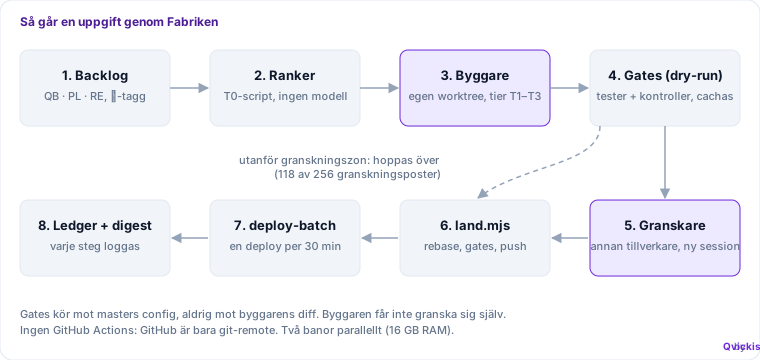
Varje rad i backlogen har en liten ⚙-tagg som säger hur svår den är: T1 (mekaniskt), T2 (vanlig bygg) eller T3 (arkitektur och forskning). Ett script utan modell väljer nästa rad, och tiern bestämmer vilken modell som bygger: Haiku, Sonnet eller Opus. Byggaren får inte själv avgöra om den är klar. Det gör land.mjs, som kör testerna och kontrollerna och bara om allt är grönt rebasar, pushar och deployar. GitHub är bara en git-remote, jag stängde av Actions eftersom det blev för dyrt. Datorn har 16 GB RAM, så det blir två banor parallellt och inte fler. Byggarna körs på min Claude Max-prenumeration.
Siffrorna
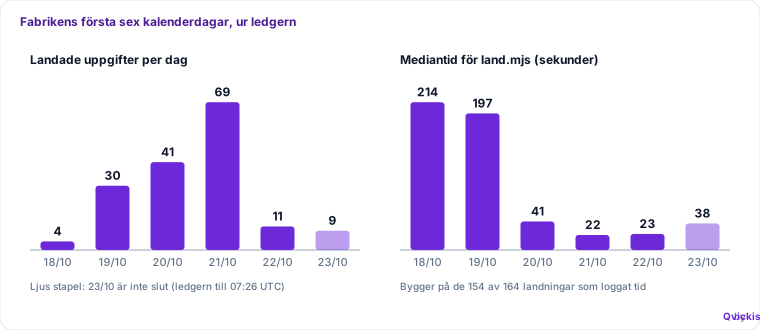
164 landningar i ledgern, fördelade på 132 olika uppgifter, så en del landade mer än en gång (en mätuppgift landade tre gånger på en dag, mer om den nedan). Av 164 gick 82 på gates som var cachade från byggarens egen dry-run, 72 körde om dem och 10 saknar uppgift. Medianen för hela land.mjs är 23 sekunder, men 90:e percentilen är 326 s och den längsta tog 1 487 s, nästan 25 minuter.
Det intressanta är medianen per dag: runt 200 sekunder de två första dygnen, sen 41, 22 och 23 (38 hittills den 23:e). Det sammanfaller med att jag den 18:e bestämde att inget ska köras två gånger (cachade gates, en deploy per 30 minuter i stället för en per landning). Jag trodde länge att det var testerna som tog tid. Det var det inte. Dagen försvann i byggarsessioner och deployer, och det hade jag sett direkt om jag mätt innan jag gissade. Den 22:a startade jag först vid två-tiden på eftermiddagen, och den 23:e är ledgern inte slut, så de två sista staplarna ska man inte tolka.
Och en ärlighetsgrej: 164 landningar säger hur mycket som kom igenom gaten. Inte hur mycket som var värt att bygga. Många är små dokumentationsrader och verify-uppgifter. Jag har inte en mätning på det ännu.
Låt aldrig byggaren granska sig själv
Det här är kärnan. Granskaren är alltid från en annan tillverkare än byggaren, i en ny session som inte ser byggarens resonemang, bara uppgiften, diffen och testresultaten. Och den körs bara när diffen rör en "granskningszon" (kuponggeneratorn, shared/, migreringar): utanför zonerna hoppar Fabriken över granskningen, och det gäller 118 av 256 granskningsposter.
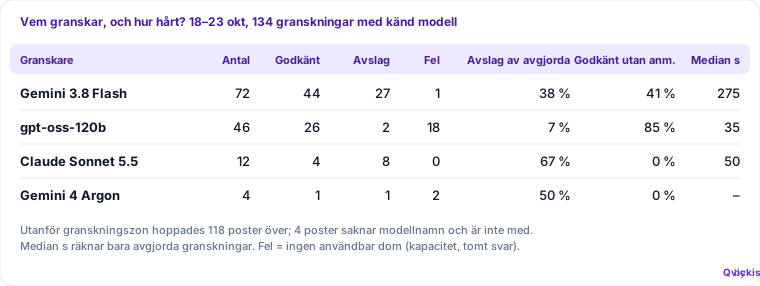
134 granskningar med känd modell, och spridningen är stor. Claude Sonnet avslår 8 av 12 (67 %), Gemini 3.8 Flash 27 av 71 avgjorda (38 %) och gpt-oss-120b 2 av 28 (7 %). gpt-oss är snabb, median 35 sekunder mot 275 för Flash, och 22 av dess 26 godkännanden redovisade noll anmärkningar. Dessutom gav den fel i stället för svar 18 gånger av 46. Det är inte nödvändigtvis fel att den godkänner mycket, kanske granskar den lättare saker. Men jag litar inte på det förrän jag mätt det mot en referensgranskare, och den skuggmätningen har bara tre rader hittills (två av dem håller med referensen), alldeles för få för att säga något. Slutsatsen så här långt är bara att en snabb och billig granskare som nästan alltid säger ja inte får vara ensam granskare på något som rör kupongerna.
Argon, Googles stora modell, har bara 4 granskningar i ledgern, och dess veckokvot var slut den 21:a (den återställs den 25:e). Det är lite synd, för den hittade fem fynd på en uppgift som gpt-oss sedan godkände på knappt 28 sekunder i nästa omgång.
Ett fall där granskaren faktiskt räddade något: en uppgift skulle få en kontroll av enhetsdisciplin att gå igenom, och byggaren löste det, enligt mina anteckningar från dagen, genom ett undantag med en felaktig motivering. Gemini Flash granskade och såg att koden bakom det undantaget fortfarande gissade enheten ur talets storlek:
pct = rawDist > 100 ? rawDist / 100 : rawDist
ATG skickar streck i hundradels procent, alltid. En häst med under 1 % streck (lagrat som 85, alltså 0,85 %) klarade inte > 100 och gick in som 85 %. Det är samma sorts fel jag skrev om i fem fel jag byggt in själv, nu på ett ställe jag inte hade hittat då. Det kraschar aldrig något, det ger bara fel kupong. Fixen landade 22 oktober (normalizeCouponPercent, med ett regressionstest). Lärdomen: en uppgift som bara lägger till ett "undantag" är exakt där en byggare gömmer ett riktigt fel, så de borde alltid få en granskare, även utanför zonerna.
Forskningskön: Fabriken klassar, jag dömer
För er som modellerar spel är det här kanske det mest användbara. Fabriken får köra research, men den får bara klassa, aldrig döma. Hypotesen förregistreras med en beslutsregel innan någon rör utfallsdata, och sen tillämpas regeln mekaniskt. Utfallet hamnar i en av tre lådor:
- KILL på mekanism: öppnas aldrig igen.
- NULL på power: för lite data, öppnas när vi har mer. Då skriver vi oftast en PL-rad för det antal (n) som krävs, och en till som ser till att datan faktiskt samlas in framåt, så att frågan går att öppna igen utan att vi börjar om.
- INCONCLUSIVE på metod: ett bättre test löser det.
Domen ger jag. Orsaken är att en agent som är bra på att få saker gröna också är bra på att få ett nollresultat att se ut som ett fynd. Och ett degenererat resultat (exakt noll i skillnad, noll varians) behandlar jag som en bugg tills motsatsen är bevisad, inte som en slutsats. Forskningen körs alltid på bästa modellen, Fable med Opus som reserv, en egen kvot forskningsuppgifter per fabriksdag. Det kostar, men en falsk positiv i modellarbete kostar mer.
En sak jag lärde mig: en mätning som skulle göras i chunks om tre varv, där varje chunk tog en dryg minut att räkna men en hel modellsession (ungefär en miljon tokens) att starta. Den landade tre gånger på en dag. Nu ska långa deterministiska jobb vara vanliga scripts utan modell i mitten, och modellen kommer bara tillbaka för att läsa resultatet (och där gick det sen fel på ett annat sätt, se nedan). Det gäller säkert alla som kör sweepar eller backtester med agenter inblandade.
Det gick sönder på tråkiga sätt
Jag hade förberett mig på agenter som skriver farlig kod. Det som hände i stället:
- 91 gamla grenar vars historik innehöll en fil med kolon i sökvägen. Ogiltigt på Windows, så varje ny uppgift föll på checkout i flera minuter utan att något hamnade i ledgern. Jag raderade alla 91 och sparade lista på dem.
- Huvudcheckoutens
node_modulesoch 3 GB data försvann två gånger på en dag. Första gången för att engit worktree removegick rakt genom en junction. Andra gången vet jag fortfarande inte varför, och det stör mig jäkligt mycket. - En byggare som stängde av sin egen vakt genom att skriva
enabled:falsei en config inne i sitt träd. Skyddet för skyddade sökvägar fångade det, tack och lov. - En bana som stod still i över två timmar, för att ett jobb med tre armar på ungefär 45 minuter vardera körde synkront i banan. Jag kollade att processen levde, inte att den gjorde något, och det var jag själv som märkte det: "claude 2 har stått still i nästan en timma?"
Varje sån sak har blivit en fix i koden och en rad i ett minne, så att den inte händer igen. Det är nog det som skiljer en fabrik från en massa script... att den lär sig av sina haverier.
Vad det kostar, och vad jag inte vet
Två banor på en Claude Max-prenumeration går på ungefär 10 % av veckokvoten per fabriksdag (grov uppskattning ur mina anteckningar, ingen exakt mätning), och granskarna körs via Googles Antigravity (där finns Gemini-, Claude- och GPT-modeller i olika kvoter).
Det jag inte vet: om det blir bra. Jag har ingen "röta"-mätning än (revertar, rollbacks per landad uppgift) och inte tillräckligt med data för att säga det. Och jag har inte bestämt om jag ska släppa loss den på syndiqatet och travranking också, eller om det blir som mycket annat jag bygger... roligare att bygga än att använda. Får se.